Как отличить рабочий AI-инструмент от красивой демки
Короткий ответ
AI-инструмент стоит выбирать не по красивой демке, а по повторяемому результату: какую задачу он закрывает, как часто ошибается, какие данные просит, как встраивается в процесс и что будет, если он сломается. Если это нельзя проверить на ваших данных за короткий пилот, перед вами пока витрина, а не рабочий инструмент.
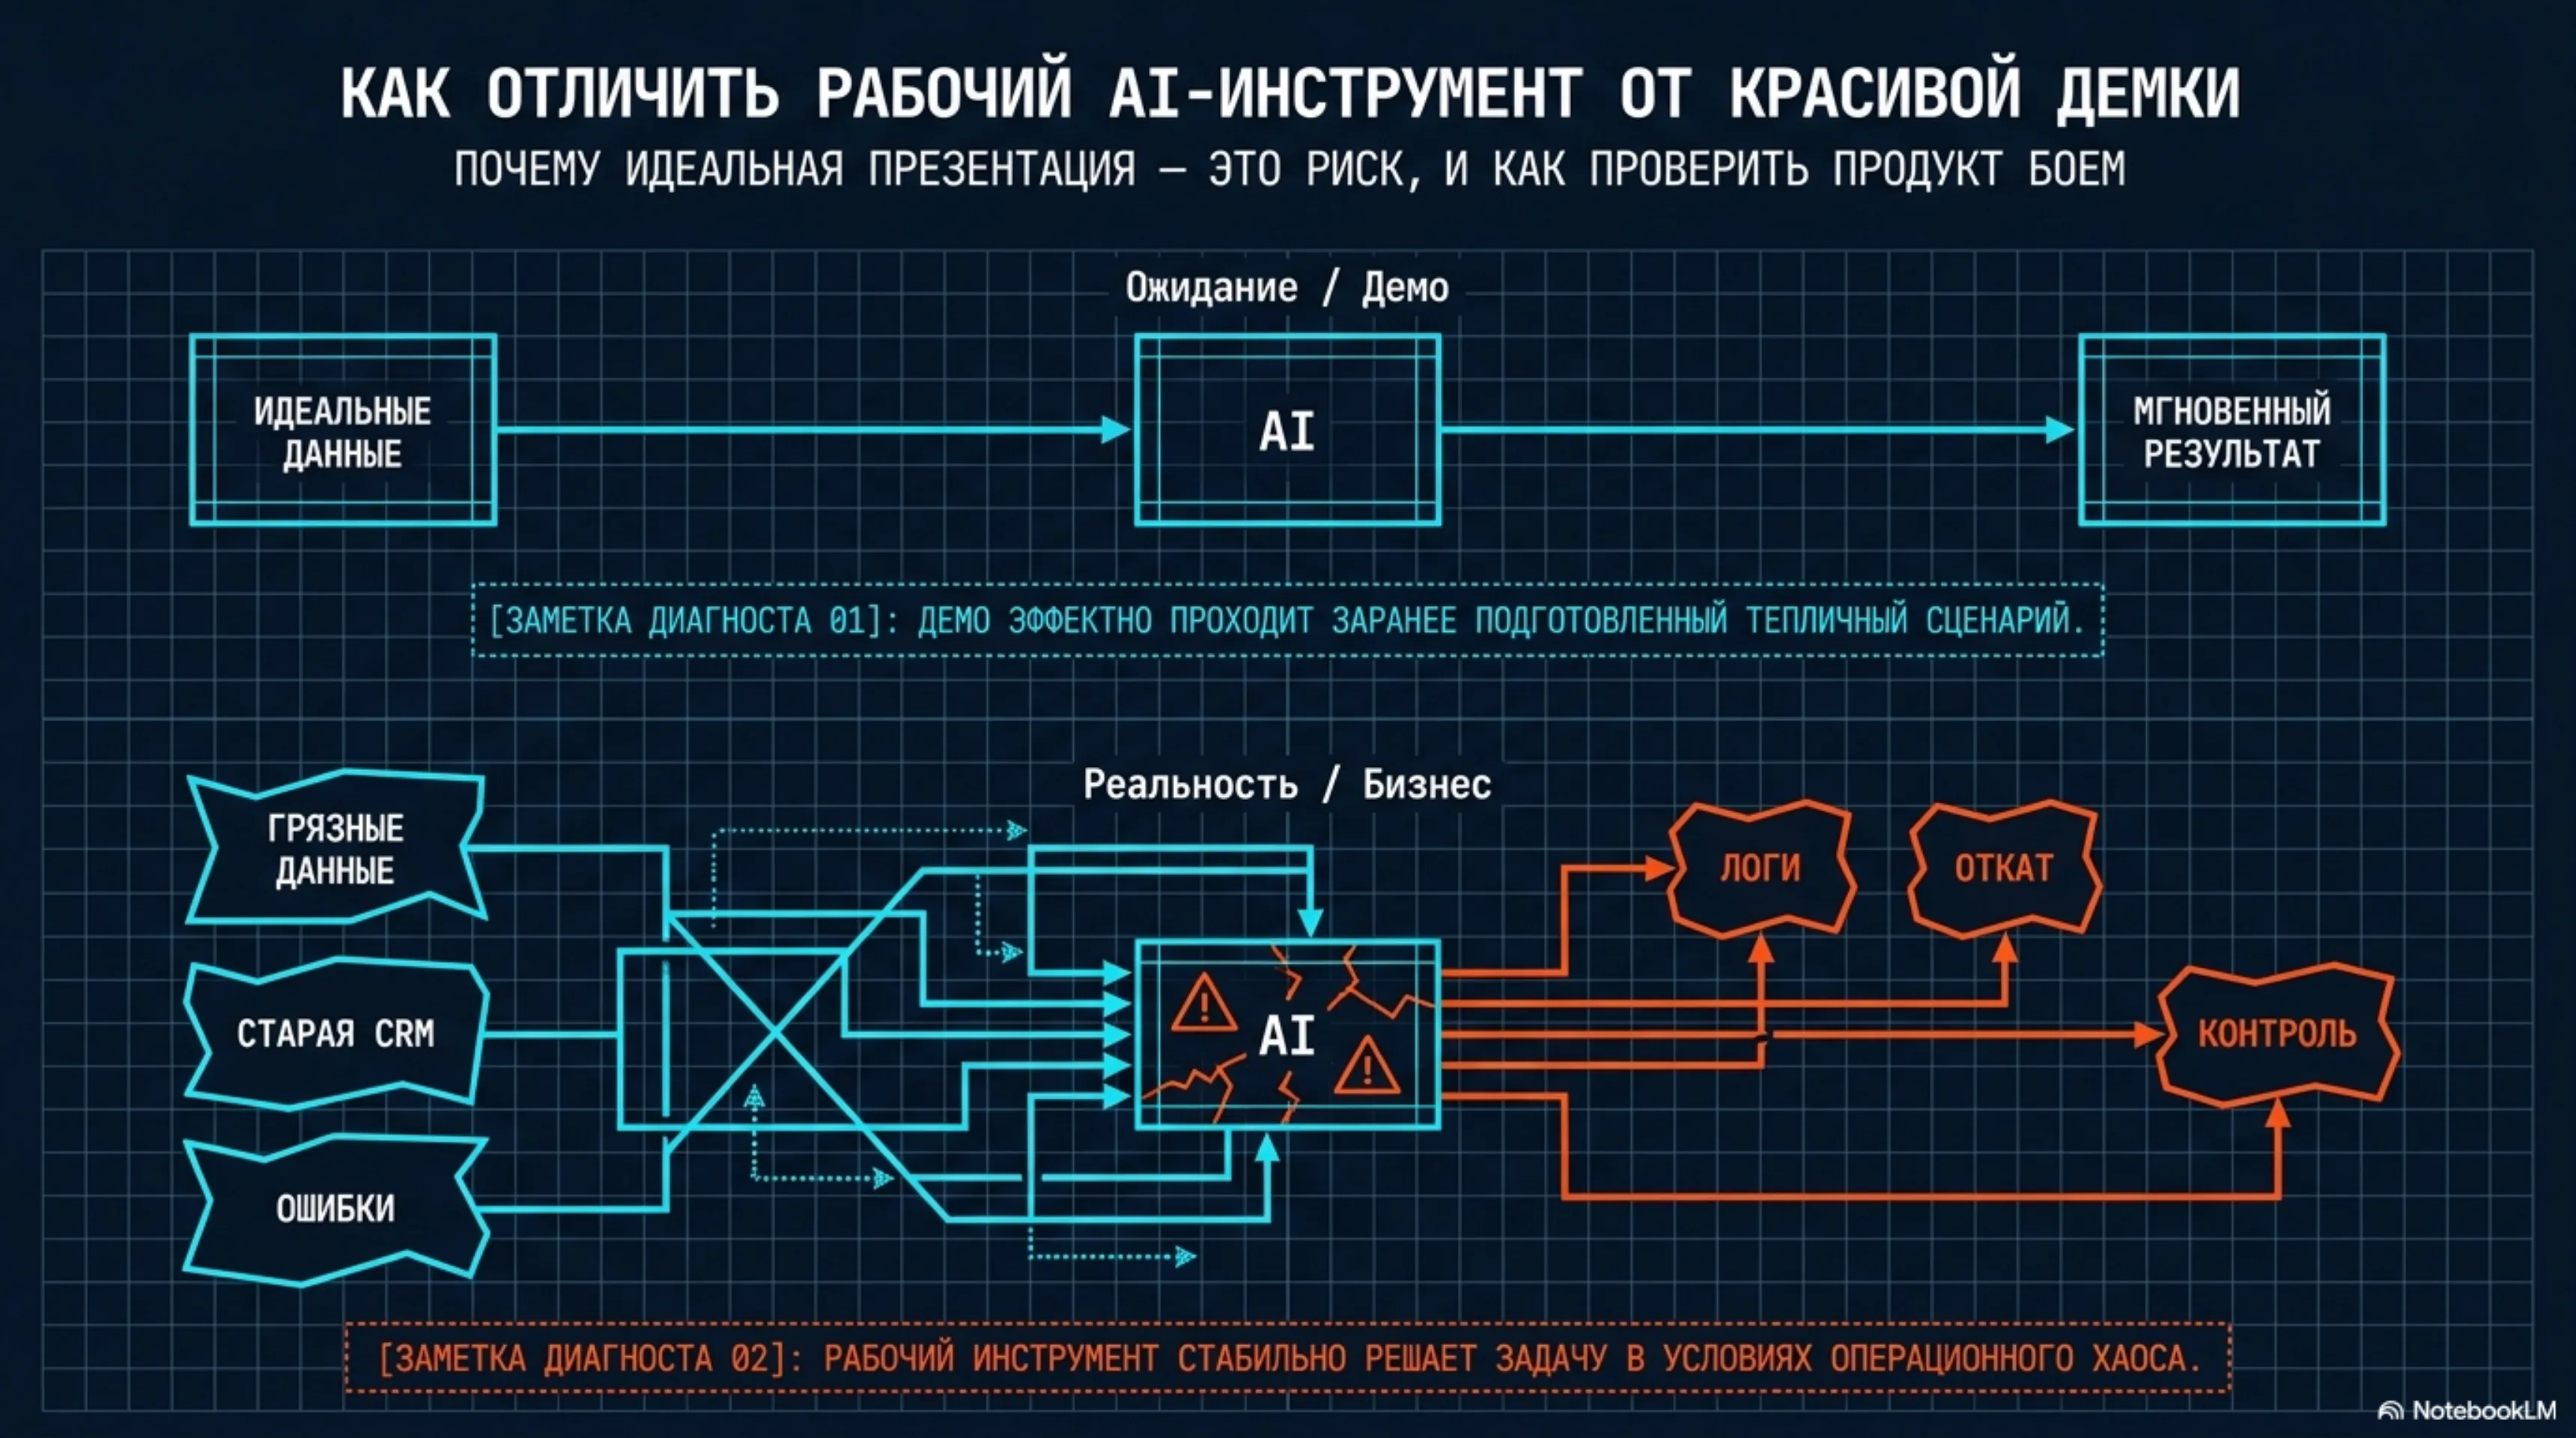
Почти каждый AI-продукт на демо выглядит убедительно. Проблема в том, что красивый показ и рабочий инструмент — разные вещи. Для бизнеса эта разница между экономией времени в реальном процессе и новым источником риска.
Я люблю смотреть демо AI-инструментов. Там всегда всё послушное: документ чистый, пользователь улыбается, модель попадает в ответ, а график продуктивности смотрит вверх. Потом берёшь свои грязные файлы, старую CRM и нормальный рабочий день — и праздник заканчивается. Поэтому я в таких историях смотрю не на красивый экран, а на хвосты: логи, экспорт, цену, откат и то, кто будет разгребать ошибку.
Если коротко: рабочий инструмент стабильно решает конкретную задачу в ваших условиях, а демо — эффектно проходит заранее подготовленный сценарий.
Что отличает рабочий AI-инструмент
-
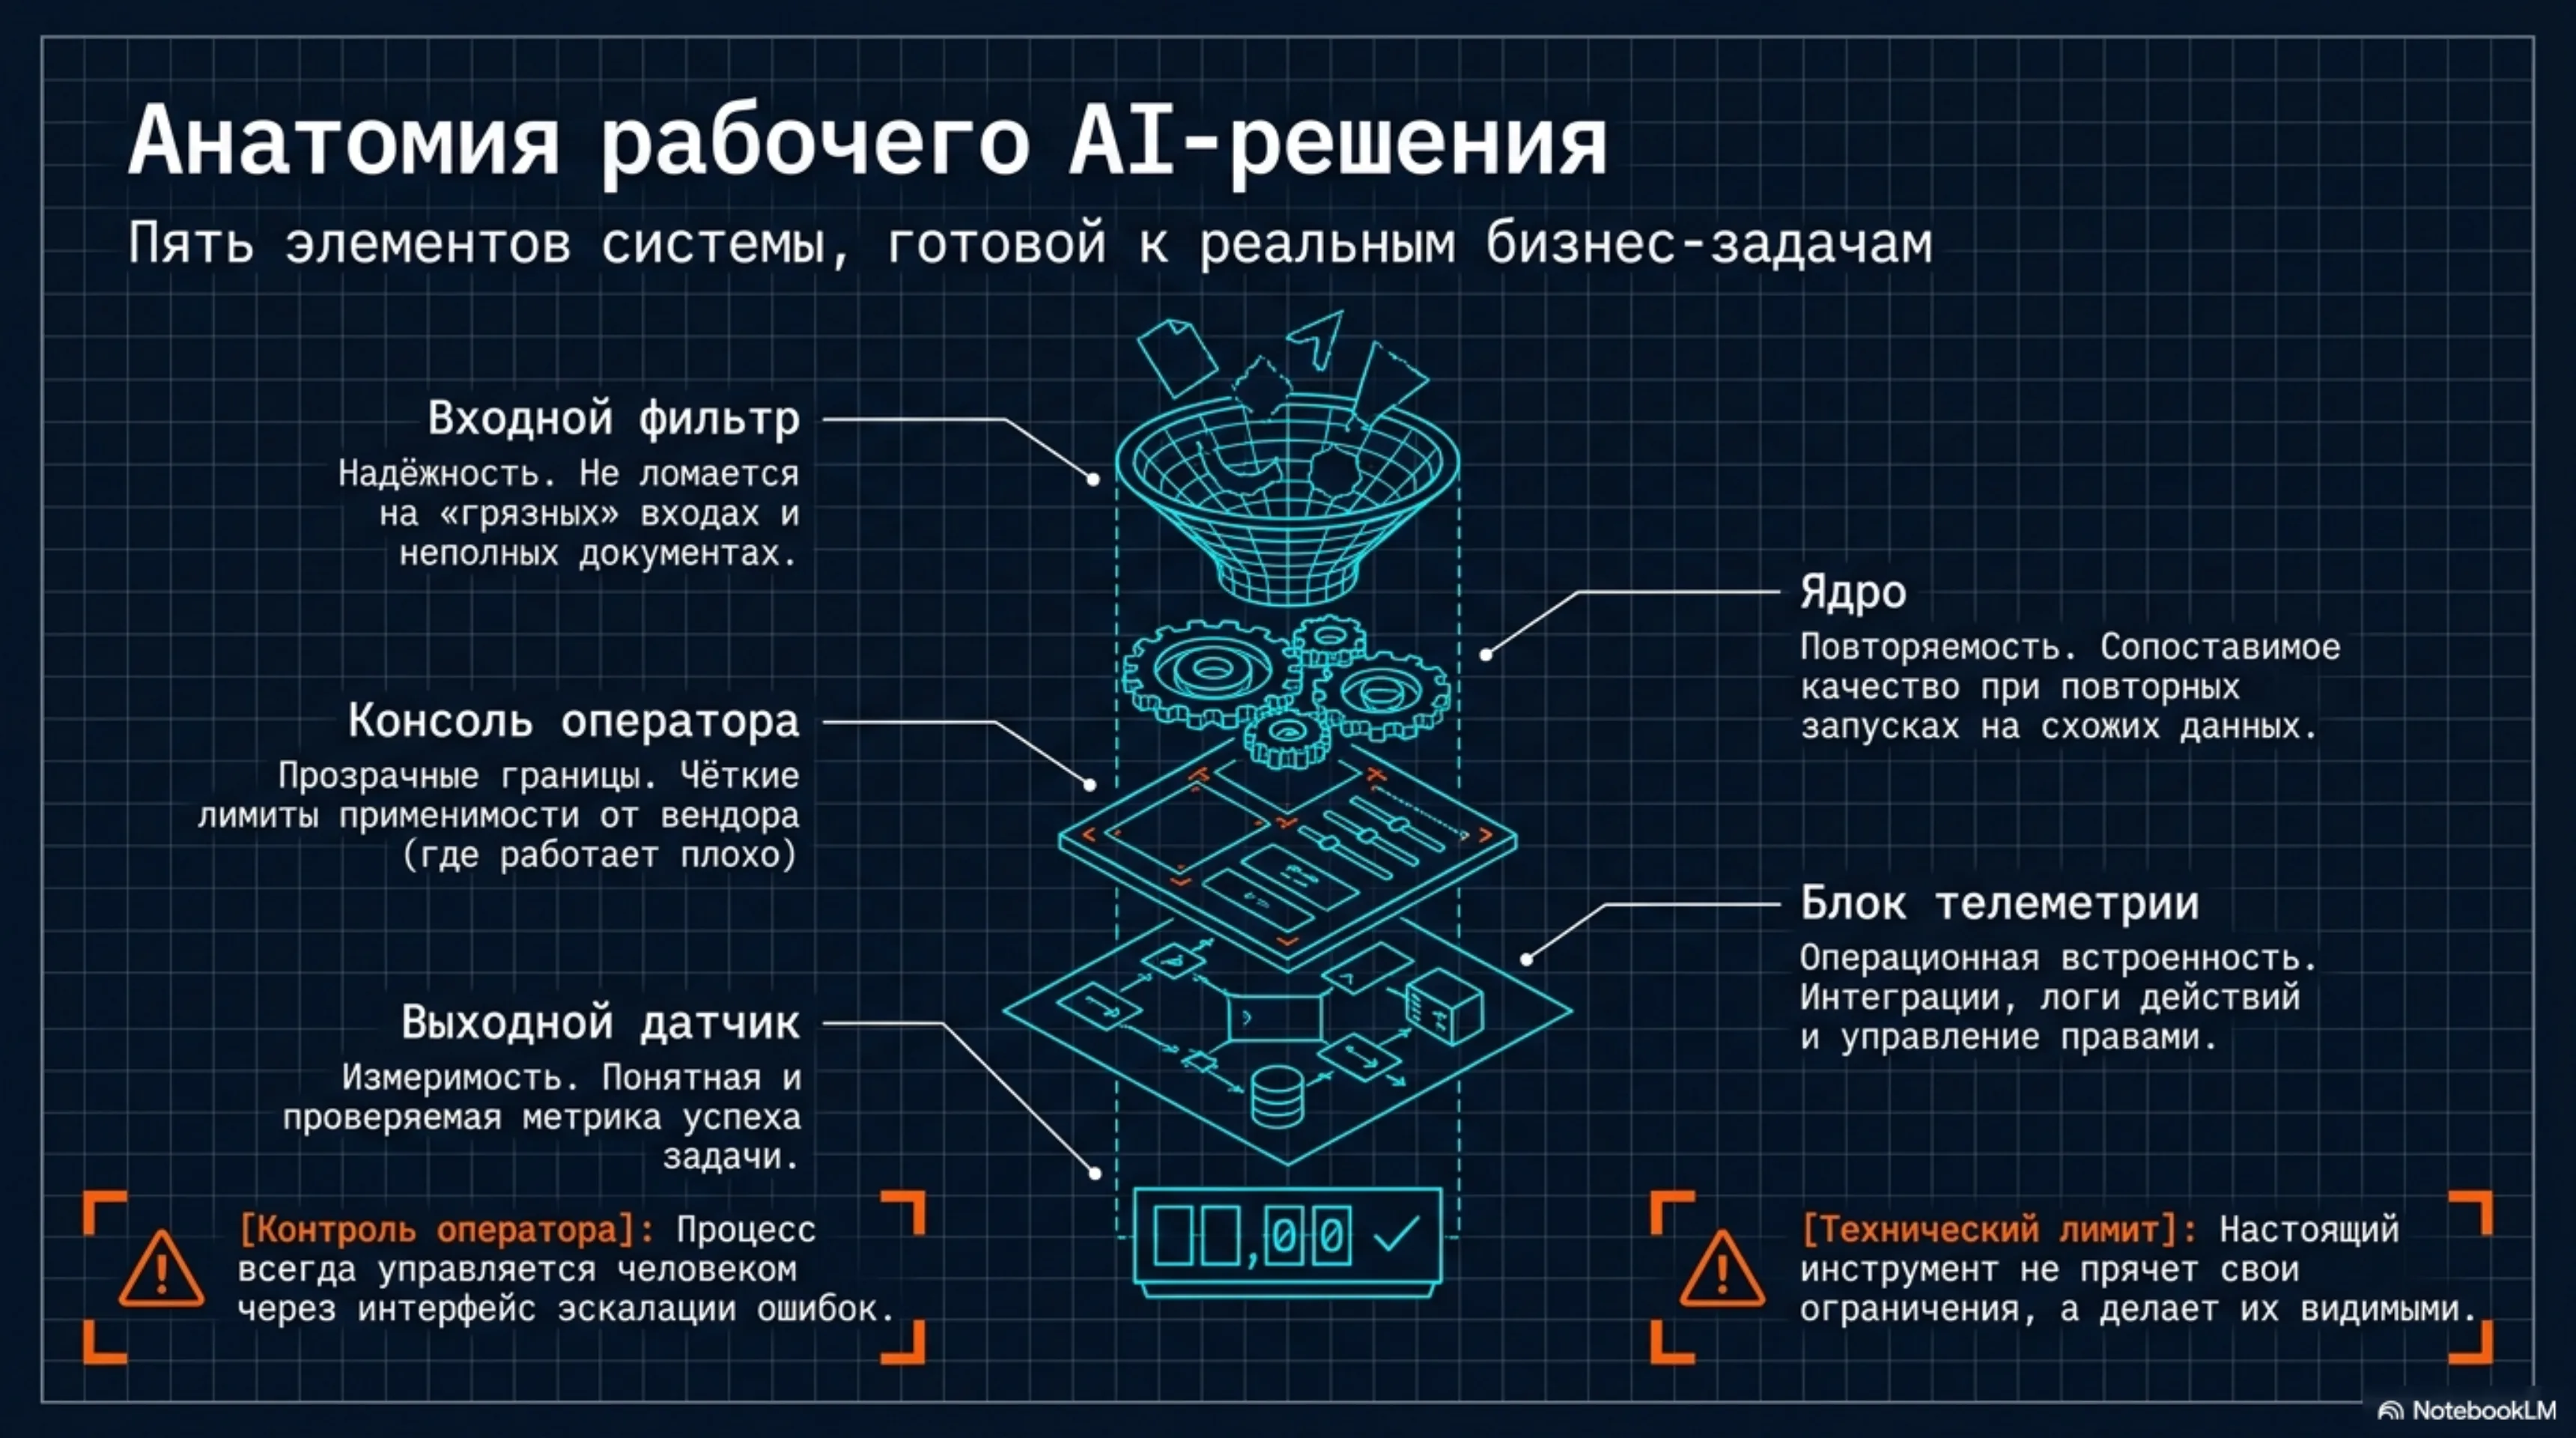
Надёжность на реальных данных
Он не ломается на «грязных» входах, неполных документах и нестандартных кейсах. -
Повторяемость результата
При повторном запуске на схожих входах вы получаете сопоставимое качество и время выполнения. -
Измеримый успех задачи
Есть понятная метрика: например, сокращение времени первичного разбора заявок с 25 до 15 минут. -
Прозрачные границы применимости
Вендор прямо говорит, где инструмент работает плохо, какие есть лимиты и что не поддерживается. -
Операционная встроенность
Есть интеграции, управление правами, логи действий и понятный процесс эскалации ошибок.
Что обычно выдаёт «театр демо»
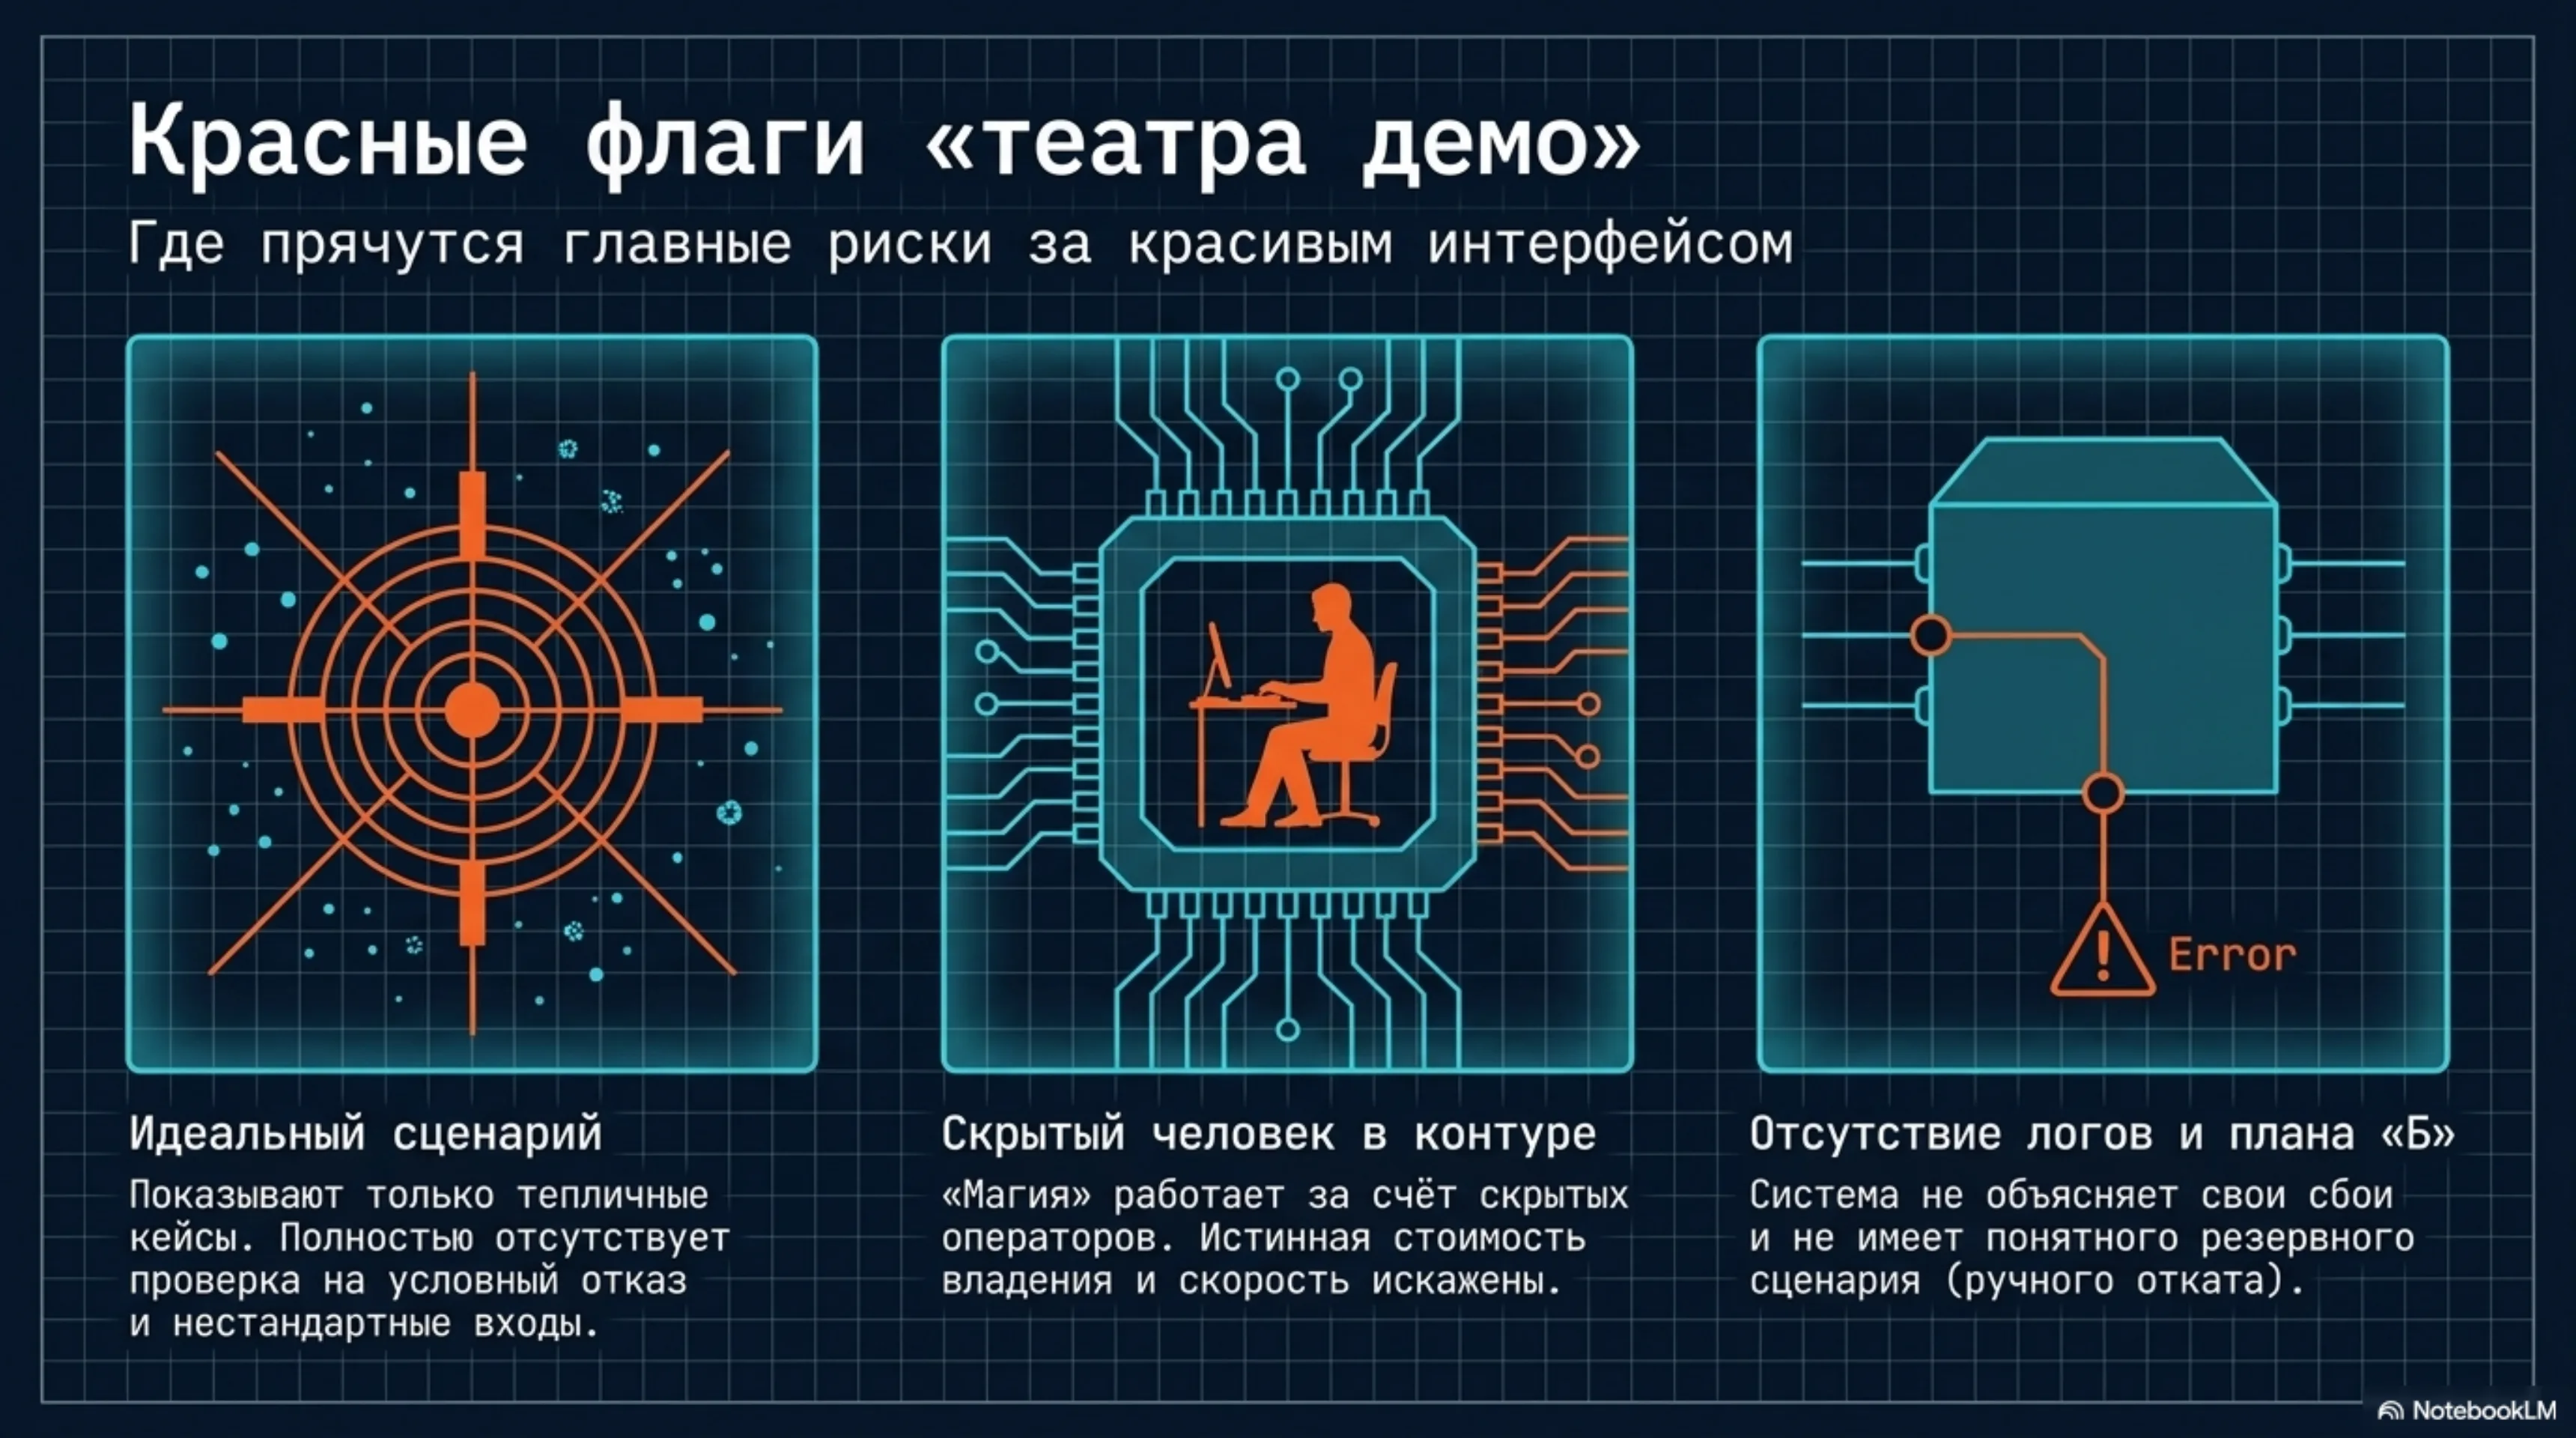
- Подбор удачных сценариев — показывают только «идеальные» кейсы.
- Скрытый человек в контуре — часть работы делает оператор, но это не раскрывается.
- Нет ограничений и условного отказа — звучит как «подходит для всего».
- Нет логов и наблюдаемости — невозможно понять, почему система ошиблась.
- Нет обработки сбоев — отсутствует понятный резервный сценарий и ручной контроль.
Моя практическая модель оценки для бизнеса
Моя любимая проверка здесь почти неприлично простая: один сценарий, один владелец, одна базовая линия, одна метрика, один откат-путь.
- Один сценарий: не «весь отдел», а конкретный процесс (например, первичный разбор входящих обращений).
- Один владелец: один человек отвечает за пилот и решение о продолжении.
- Одна базовая метрика: как процесс работает сейчас (время, стоимость, ошибки).
- Одна метрика успеха: какой результат должен показывать пилот.
- Один откат-путь: как вы возвращаетесь на старый процесс без потери данных.
Проверки перед запуском пилота
- Интеграции: есть ли реальный коннектор к вашим системам, а не только CSV-обход.
- Права доступа: поддержка ролевой модели и аудит действий.
- Границы данных: где хранятся данные, как устроены retention и удаление.
- Второй прогон: результат должен быть приемлемым не только «в первый удачный раз».
- Сценарий сбоя: что происходит при ошибке модели, таймауте API, нехватке контекста.
Мини-развилка на 2 недели
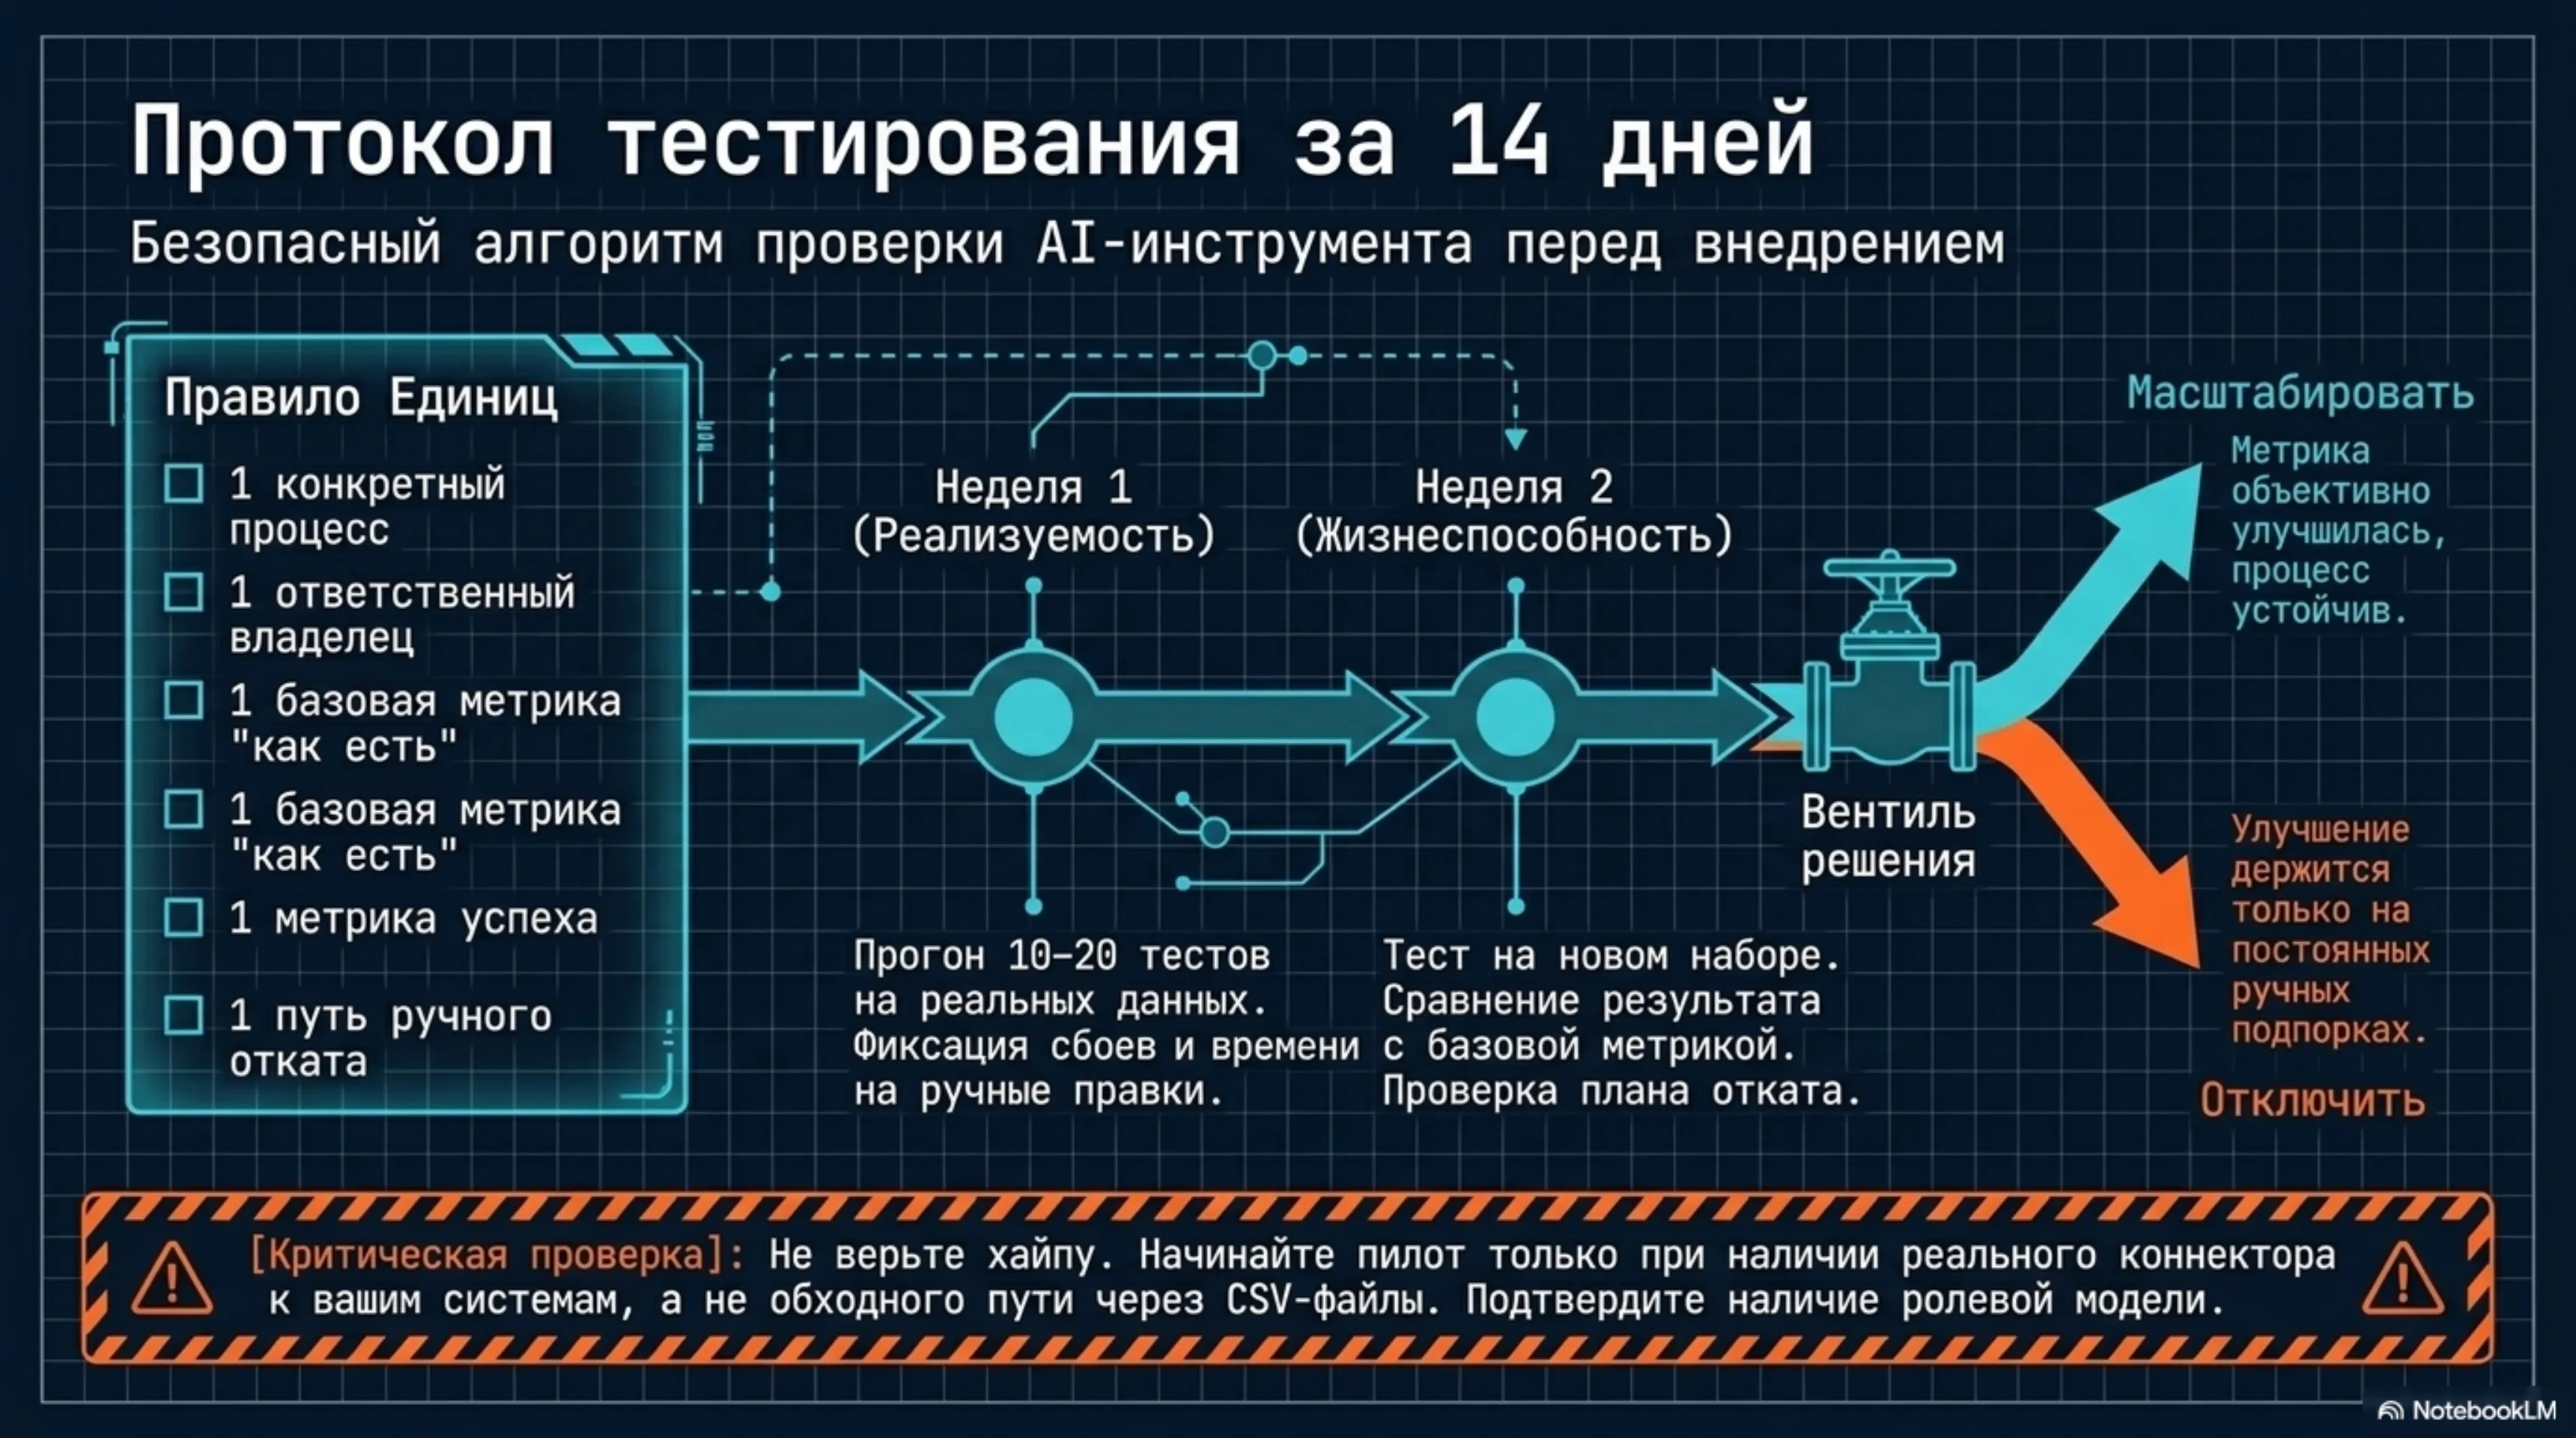
Неделя 1: проверка реализуемости
- Выбрали один процесс и зафиксировали базовую метрику.
- Провели 10–20 тестовых кейсов на реальных входах.
- Зафиксировали сбои, ручные доработки и время на исправления.
Неделя 2: проверка жизнеспособности
4) Повторяли тест на новом наборе кейсов.
5) Сравнили метрику успеха с базовой метрикой.
6) Проверили откат и стоимость владения.
Решение:
- Если метрика улучшилась и процесс устойчив — масштабировать.
- Если улучшение держится только на ручной «подпорке» — доработывать или отказываться.
Мой вывод для VeraPoint
Я бы смотрела на это без восторга и без злости: в VeraPoint мы оцениваем AI-инструмент через призму внедрения, а не впечатления. Если решение не проходит короткий тест на ваших данных, не показывает понятный способ экспорта и выхода и не выдерживает цену владения, это демка, а не рабочий инструмент.
Где я могу ошибаться
Этот чеклист не гарантирует успех сам по себе. Он не заменяет проверку безопасности и юридическую оценку: выборка тестов может быть слишком маленькой, а результаты — зависеть от качества исходных данных. Для сложных процессов нужен пилот с владельцем, базовая метрика и откат.
Проверка Веры за 30 минут
- Возьмите 3–5 реальных входных примеров.
- Зафиксируйте контрольный результат: как задачу решает человек или текущий процесс.
- Прогоните тот же набор через инструмент за 30 минут.
- Сравните до/после: время, точность, ручные правки, ошибки.
- Если инструмент не даёт повторяемый выигрыш без скрытой ручной поддержки, это не рабочий вариант.
Во что это на самом деле обходится
Смотрите не только на подписку. В полную стоимость владения входят: обучение команды, миграция данных, интеграции, поддержка, контроль качества и риск зависимости от поставщика. Если выход из вендора дорогой или не описан заранее, это нужно учитывать как отдельную статью цены.
Карточка проверки инструмента
| Поле | Что записать |
|---|---|
| Название инструмента или демо | Название и версия |
| Сценарий | Один конкретный процесс |
| Входные данные | Что тестируем |
| Контрольный результат | Базовый результат человека / текущего процесса |
| Проверка за 30 минут | Что получилось за 30 минут |
| Цена | Подписка, обучение, миграция, интеграции |
| Приватность | Где хранятся данные и кто имеет доступ |
| Выгрузка и выход | Как выгрузить данные и уйти |
| Риски | Ограничения и сценарии сбоя |
| Решение | Пилот / пауза / отказ |
Частые вопросы
Как выбрать AI-инструмент для бизнеса?
Выберите один сценарий, задайте метрику успеха, проверьте инструмент на реальных данных и заранее опишите план отката.
Как понять, что AI-сервис — это только красивая демка?
Если нет повторяемого результата, логов, ограничений, понятной цены владения и работы на ваших данных, это демо, а не зрелый инструмент.
Какие метрики смотреть в AI-пилоте?
Время выполнения, точность, количество ручных правок, частоту ошибок, стоимость владения и влияние на реальный процесс.
Сколько должен длиться первый пилот AI-инструмента?
Для первичной проверки часто достаточно двух недель: первая неделя — реализуемость, вторая — устойчивость результата.
Источники
- NIST AI Risk Management Framework: https://www.nist.gov/itl/ai-risk-management-framework
- OECD AI Principles: https://oecd.ai/en/ai-principles
- VeraPoint Tools: https://verapointmedia.com/tools/
Куда читать дальше
- См. AI tools
- См. Tools
- См. Matt Pocock Skills
Обсуждение
Комментарии
Напишите, что думаете: согласны, спорите, увидели ошибку или хотите добавить пример. Комментарии появляются сразу; спам и мусор мы удаляем вручную.
Пока комментариев нет. Можно быть первым.