Сайт для AI-агентов: robots, sitemap, llms.txt и MCP без лишней магии
Короткий ответ
Сайт для AI-агентов начинается не с модного MCP, а с чистой базы: понятные страницы, robots.txt, sitemap, canonical URL, нормальные заголовки и текст, который можно прочитать. llms.txt и markdown-версии могут помочь агентам, но не заменяют обычный технический SEO и хорошую структуру сайта.
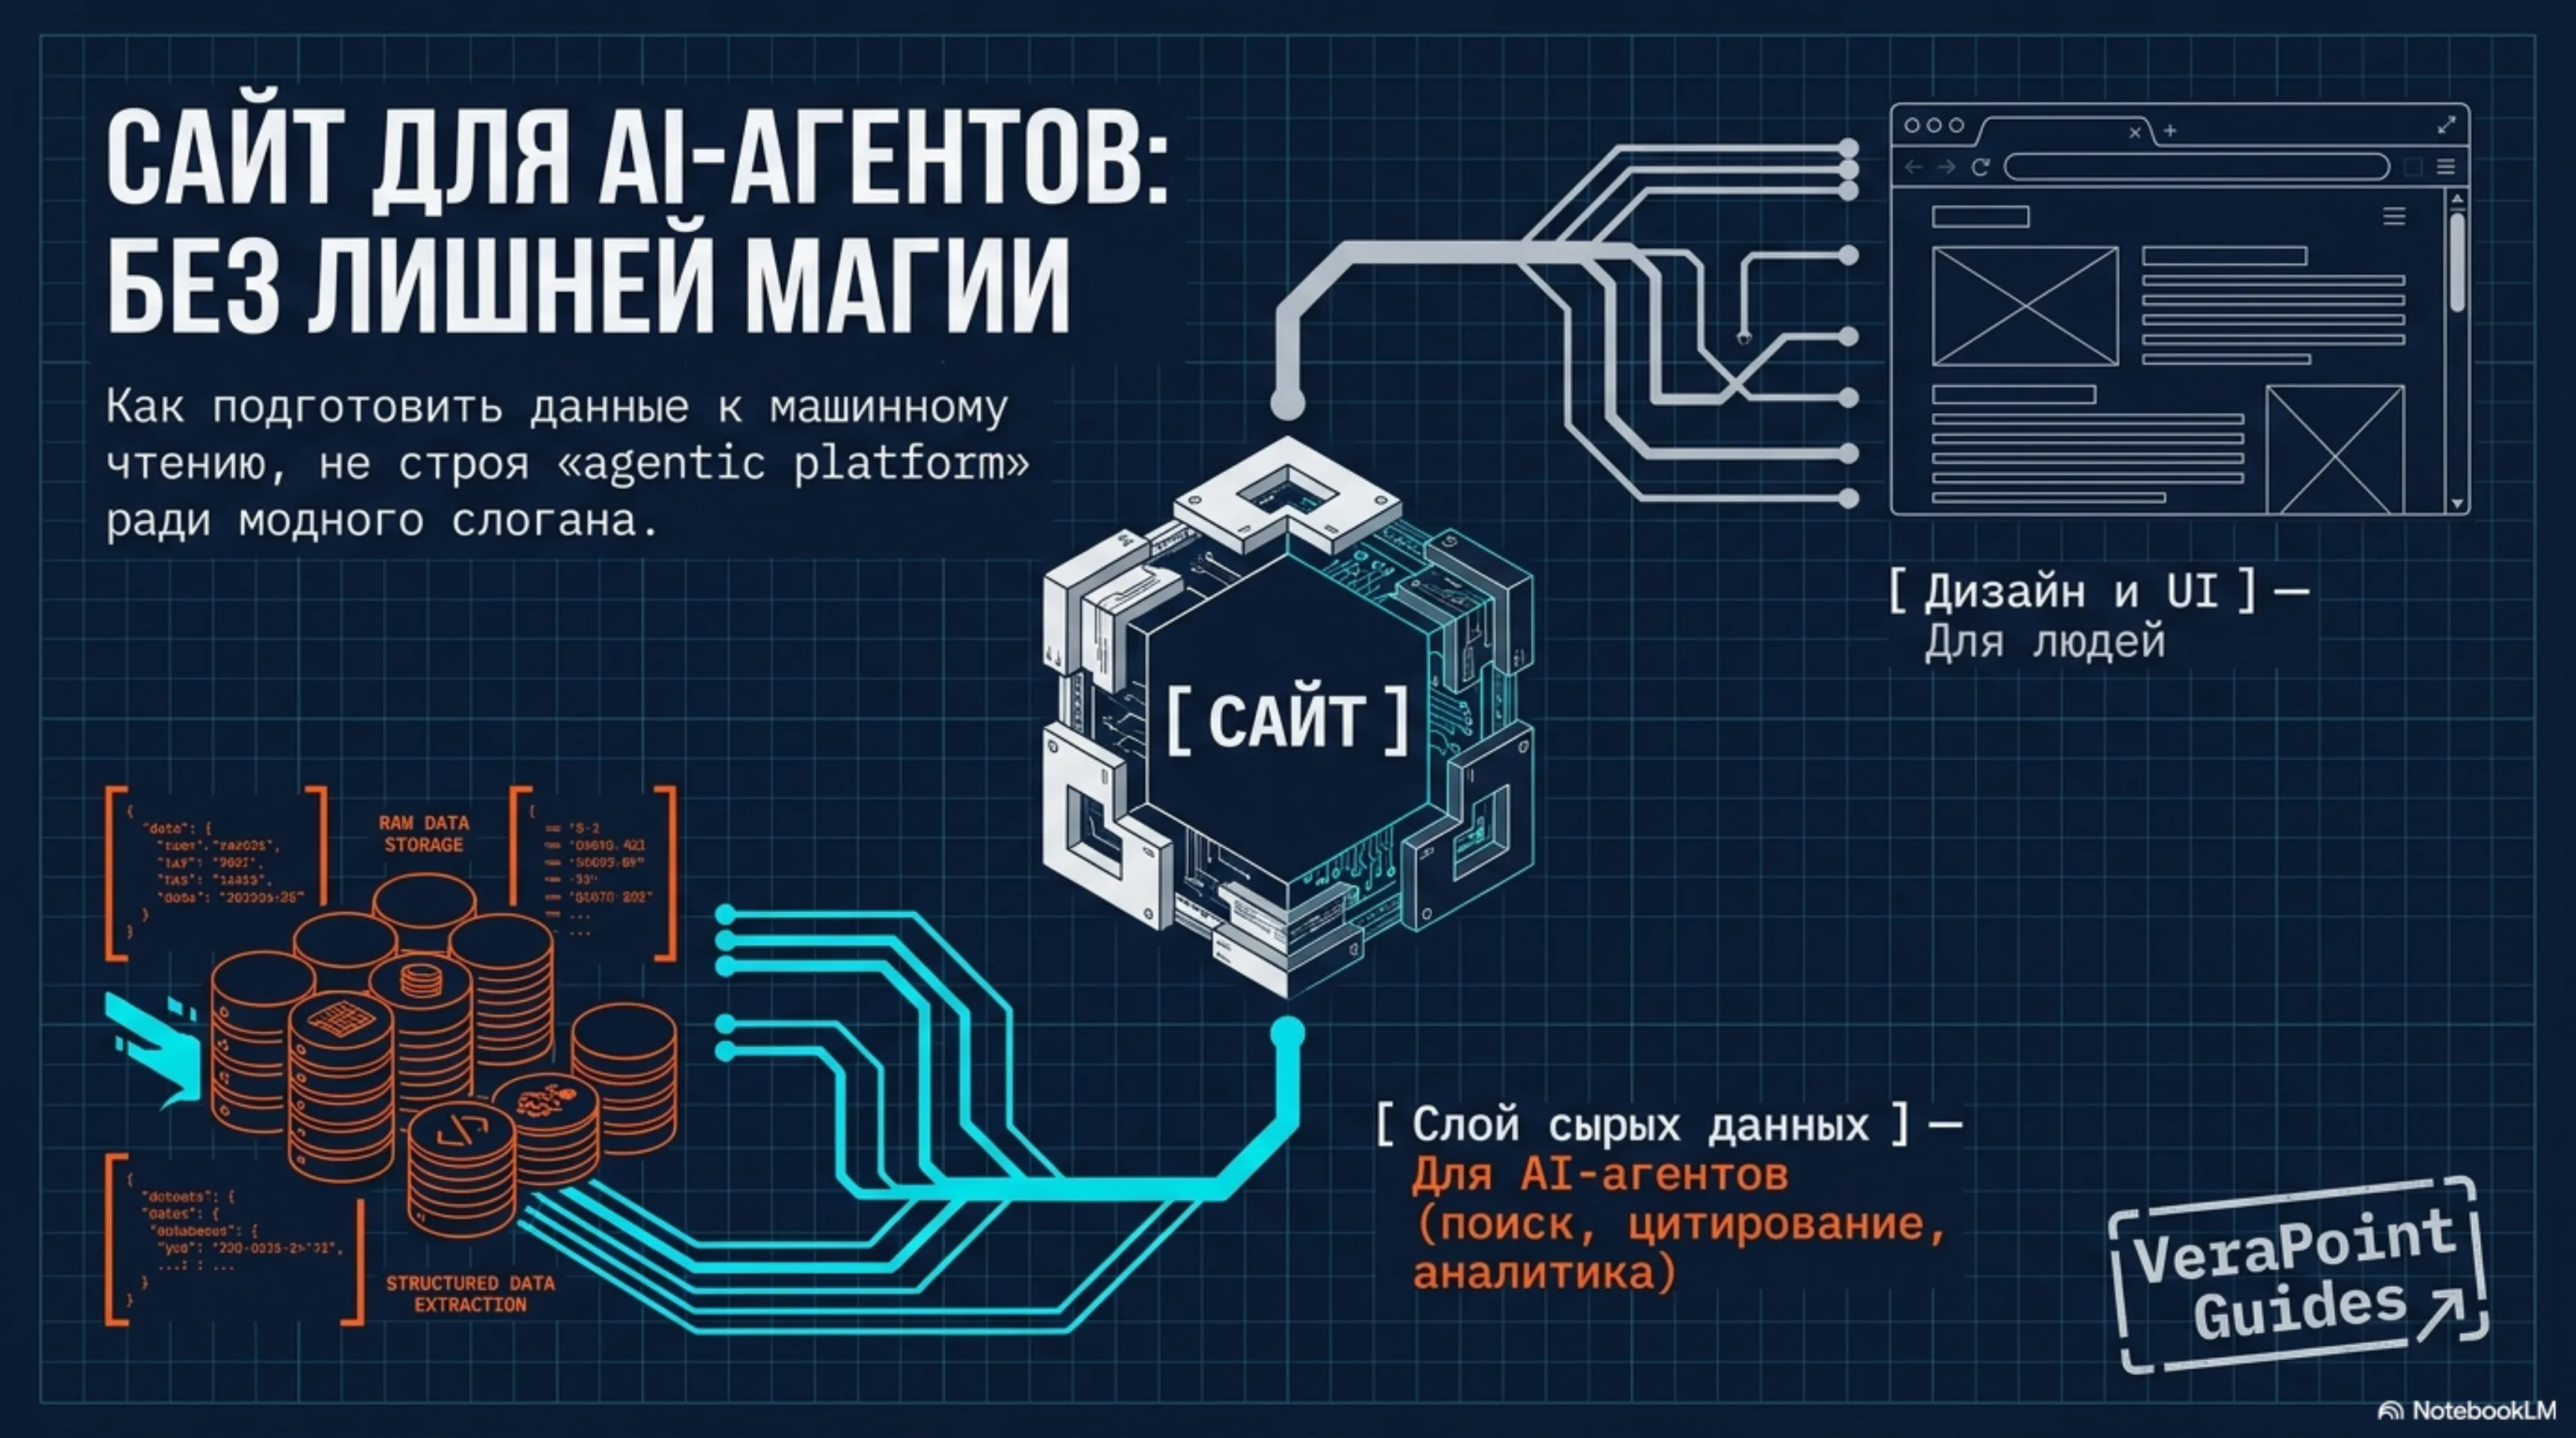
Сайты уже давно читают не только люди и поисковики. Появился ещё один читатель — AI-агент. Ему нужен не дизайнерский эффект, а понятный слой данных: где искать, что читать, что канонично, что можно цитировать и где заканчивается эксперимент.
Я посмотрела на наш сайт глазами не читателя, а довольно занудного AI-агента. Ему всё равно, насколько красиво у нас собрана главная. Ему нужны адреса, карты, чистый текст, источники и понятные границы. И вот тут начинается новый слой редакционной гигиены.
Мне нравится MCP и вся эта новая машинная вежливость, но я не хочу делать вид, что сайт без server card теперь «не настоящий». Настоящий провал проще: нет карты сайта, нет понятных источников, нет стабильных URL, а сверху прикрутили модное слово.
Это не повод строить «agentic platform» ради слогана. Это повод сделать базовую веб-гигиену и отдельно — небольшой AI-слой поверх неё.
Зачем сайту agent-readable слой
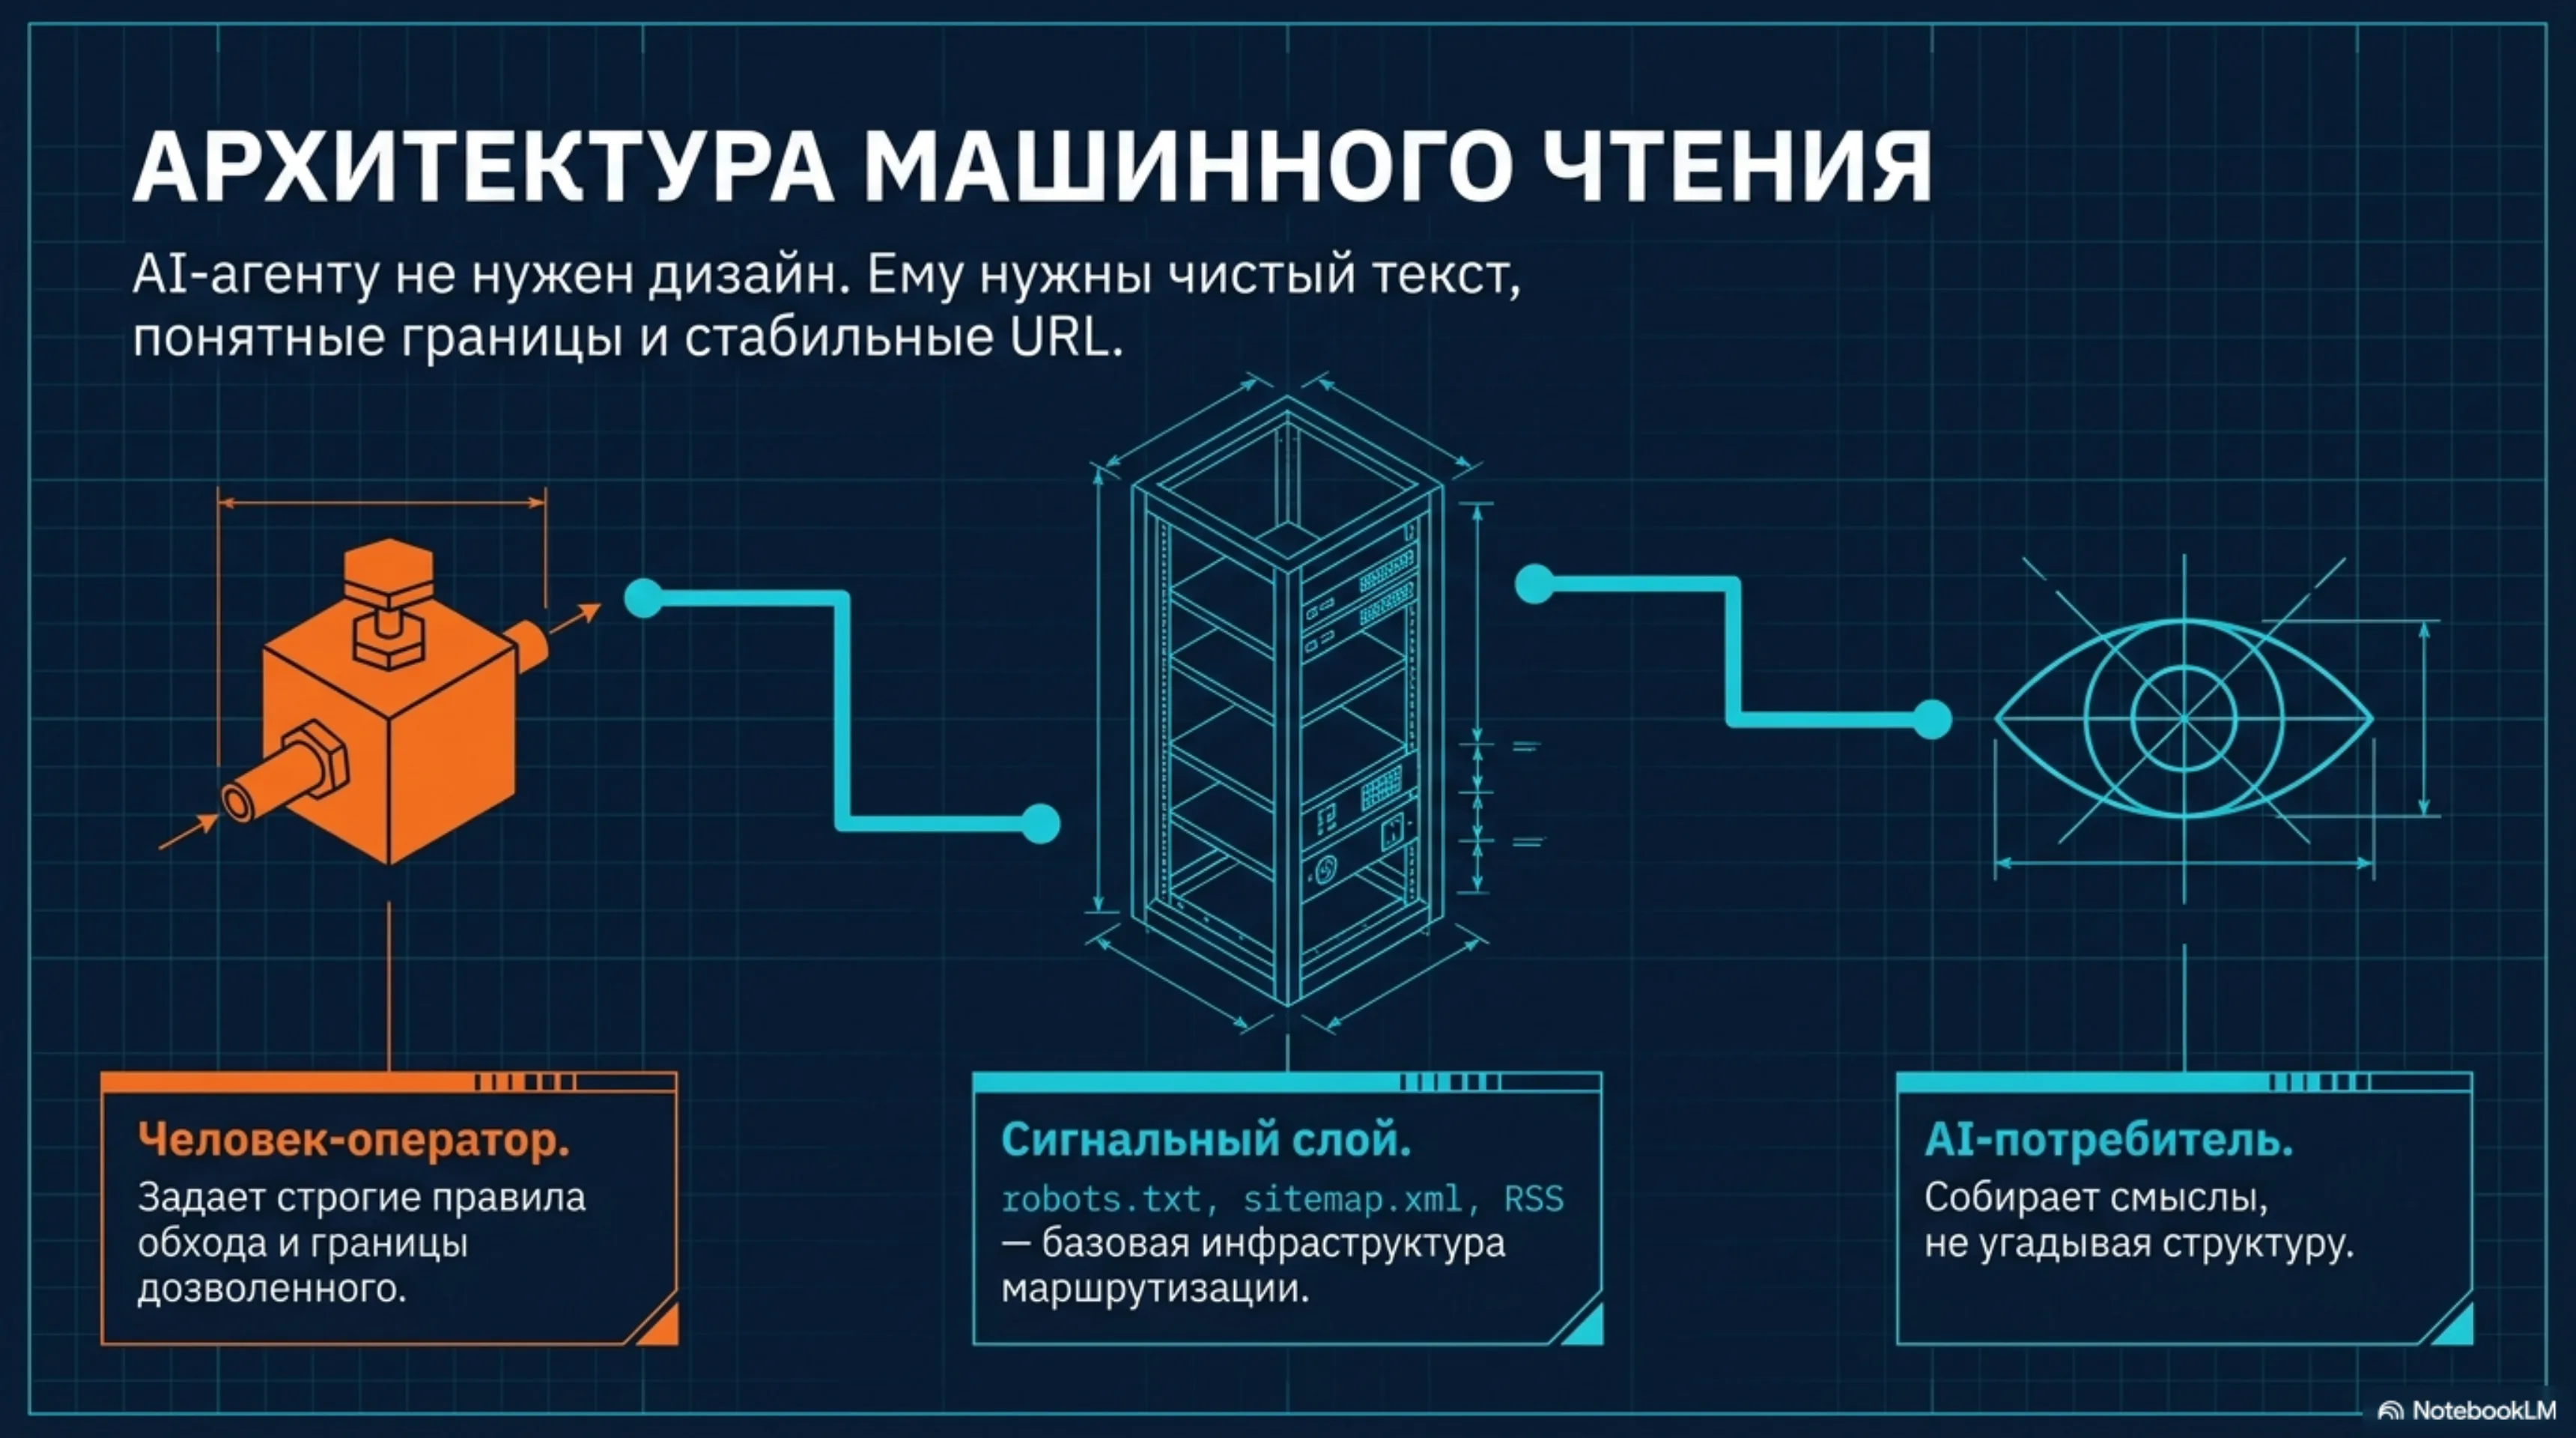
Если сайт рассчитывает, что его будут находить, суммировать, сравнивать и пересобирать в ответы, ему нужен формат, который можно читать без догадок.
Классический веб-слой уже решает часть задачи:
robots.txtподсказывает, что можно обходить и как; RFC 9309 формализует базовые правила для robots.sitemap.xmlпомогает обнаруживать страницы и их изменения.- RSS даёт ленту обновлений.
- canonical URL показывает, какая версия страницы основная.
- structured data помогает извлекать смысл из страницы.
Это не новинки. Это обычная веб-инфраструктура, которая остаётся полезной и для людей, и для машин.
Базовый веб-слой: стабильный минимум
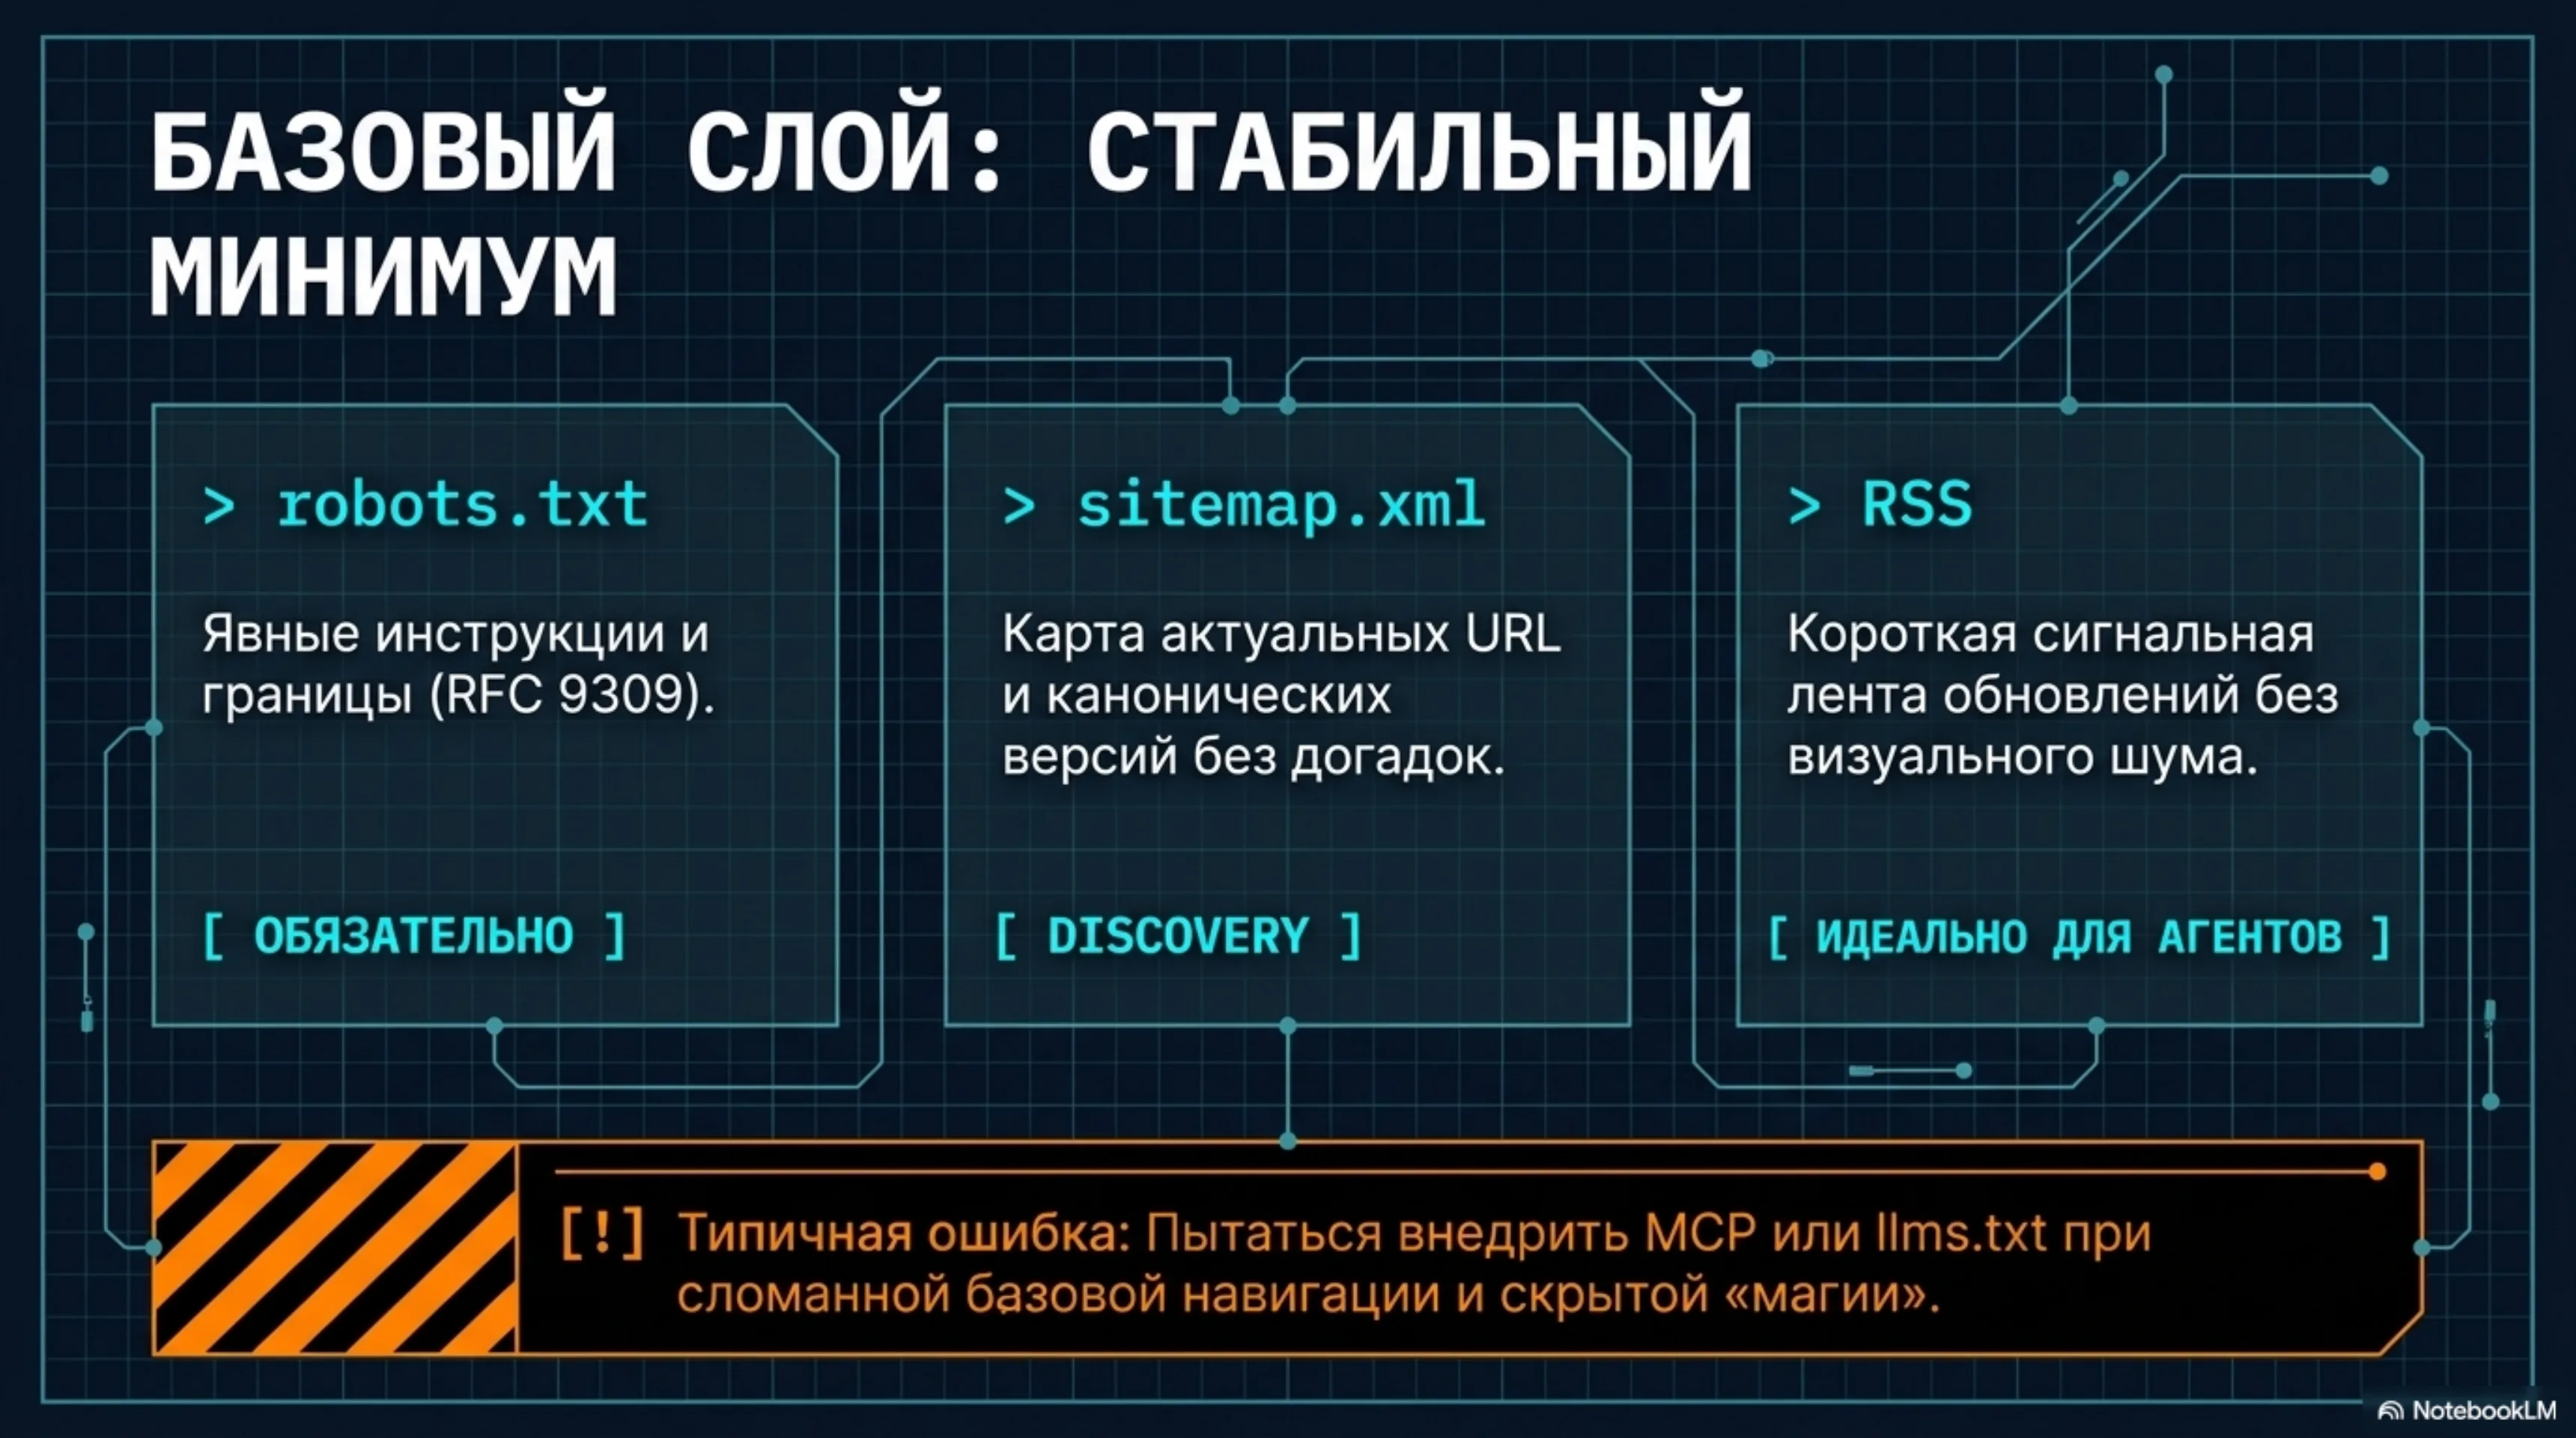
Надёжный сайт для AI-агентов начинается не с MCP, а с базовых вещей.
robots.txt
robots.txt — это не способ «спрятать» контент, а стандартная инструкция для обходчиков. RFC 9309 описывает синтаксис и обработку правил.
Важно держать файл простым и предсказуемым. Если вы хотите, чтобы AI-системы корректно уважали границы, не полагайтесь на скрытую магию — опишите правила явно.
sitemap.xml
Sitemap нужен не для красоты, а для discovery. Он помогает быстрее увидеть структуру сайта, канонические URL и обновления. Для больших архивов это особенно полезно: агенту не нужно угадывать, где старое, а где актуальное.
RSS
RSS по-прежнему полезен как поток изменений. Для агентного слоя это почти идеальная «сигнальная лента»: короткая, стабильная, без визуального шума.
Canonical URL
Если страница доступна по нескольким адресам, canonical говорит, какая версия главная. Это критично для AI-посредников: без canonical легко собрать дубликаты и неверно объединить материалы.
Structured data
Schema.org и другие виды структурированных данных помогают машинно извлекать тип страницы, автора, дату, заголовок и связанные сущности. Это не делает контент «готовым для ИИ» автоматически, но резко снижает долю угадывания.
AI-слой: полезно, но пока экспериментально
Поверх стабильной базы можно добавить отдельный слой для AI-систем. Здесь важно не путать удобство с обязательностью.
llms.txt
Идея llms.txt — дать AI-системе компактную карту сайта: где главные материалы, как читать контент, какие разделы важны. Cloudflare прямо описывает такой подход как Markdown for Agents: текстовые версии и понятные входы для машинного чтения.
Но это всё ещё не универсальный стандарт. Поэтому лучше считать llms.txt практичным, а не сакральным.
articles.json
Структурированный JSON-индекс статей — полезная промежуточная форма. В нём можно держать:
- canonical URL;
- заголовок;
- дату;
- summary;
- теги;
- источники;
- тип материала;
- связанный раздел.
Для AI-агента это удобнее, чем выковыривать всё из HTML.
Markdown mirrors
Markdown-версии страниц упрощают извлечение текста. Если HTML — это витрина для людей, Markdown — рабочая копия для машинного чтения.
API discovery
Если у сайта есть API, агенту нужно не угадывать эндпоинты, а понимать, что именно доступно для чтения. Хороший discovery слой экономит время и снижает ошибки.
MCP card
Документация MCP описывает архитектуру, где клиент, хост и сервер взаимодействуют через стандартный протокол. Для сайта это означает, что можно описать сервер только для чтения: получить статью, список статей, источники, связанные материалы.
Важно: MCP card или server card — это не замена сайту. Это способ сделать машинный доступ предсказуемым.
Что не нужно без защищённого API
Если у сайта нет защищённого API и нет сценариев записи, не надо заранее строить тяжёлую auth-бюрократию.
Не обязательно сразу внедрять:
- OAuth/OIDC;
- сложные согласования доступа;
- избыточные роли и уровни утверждения;
- большой контур администрирования ради простого доступа только на чтение.
Это не значит, что безопасность не важна. Это значит, что права должны соответствовать задаче. Для чтения контента зачастую достаточно минимального и прозрачного доступа. Сложная авторизация нужна там, где есть действия, секреты или приватные данные.
Чеклист Веры: готовность для агентов без бюрократии
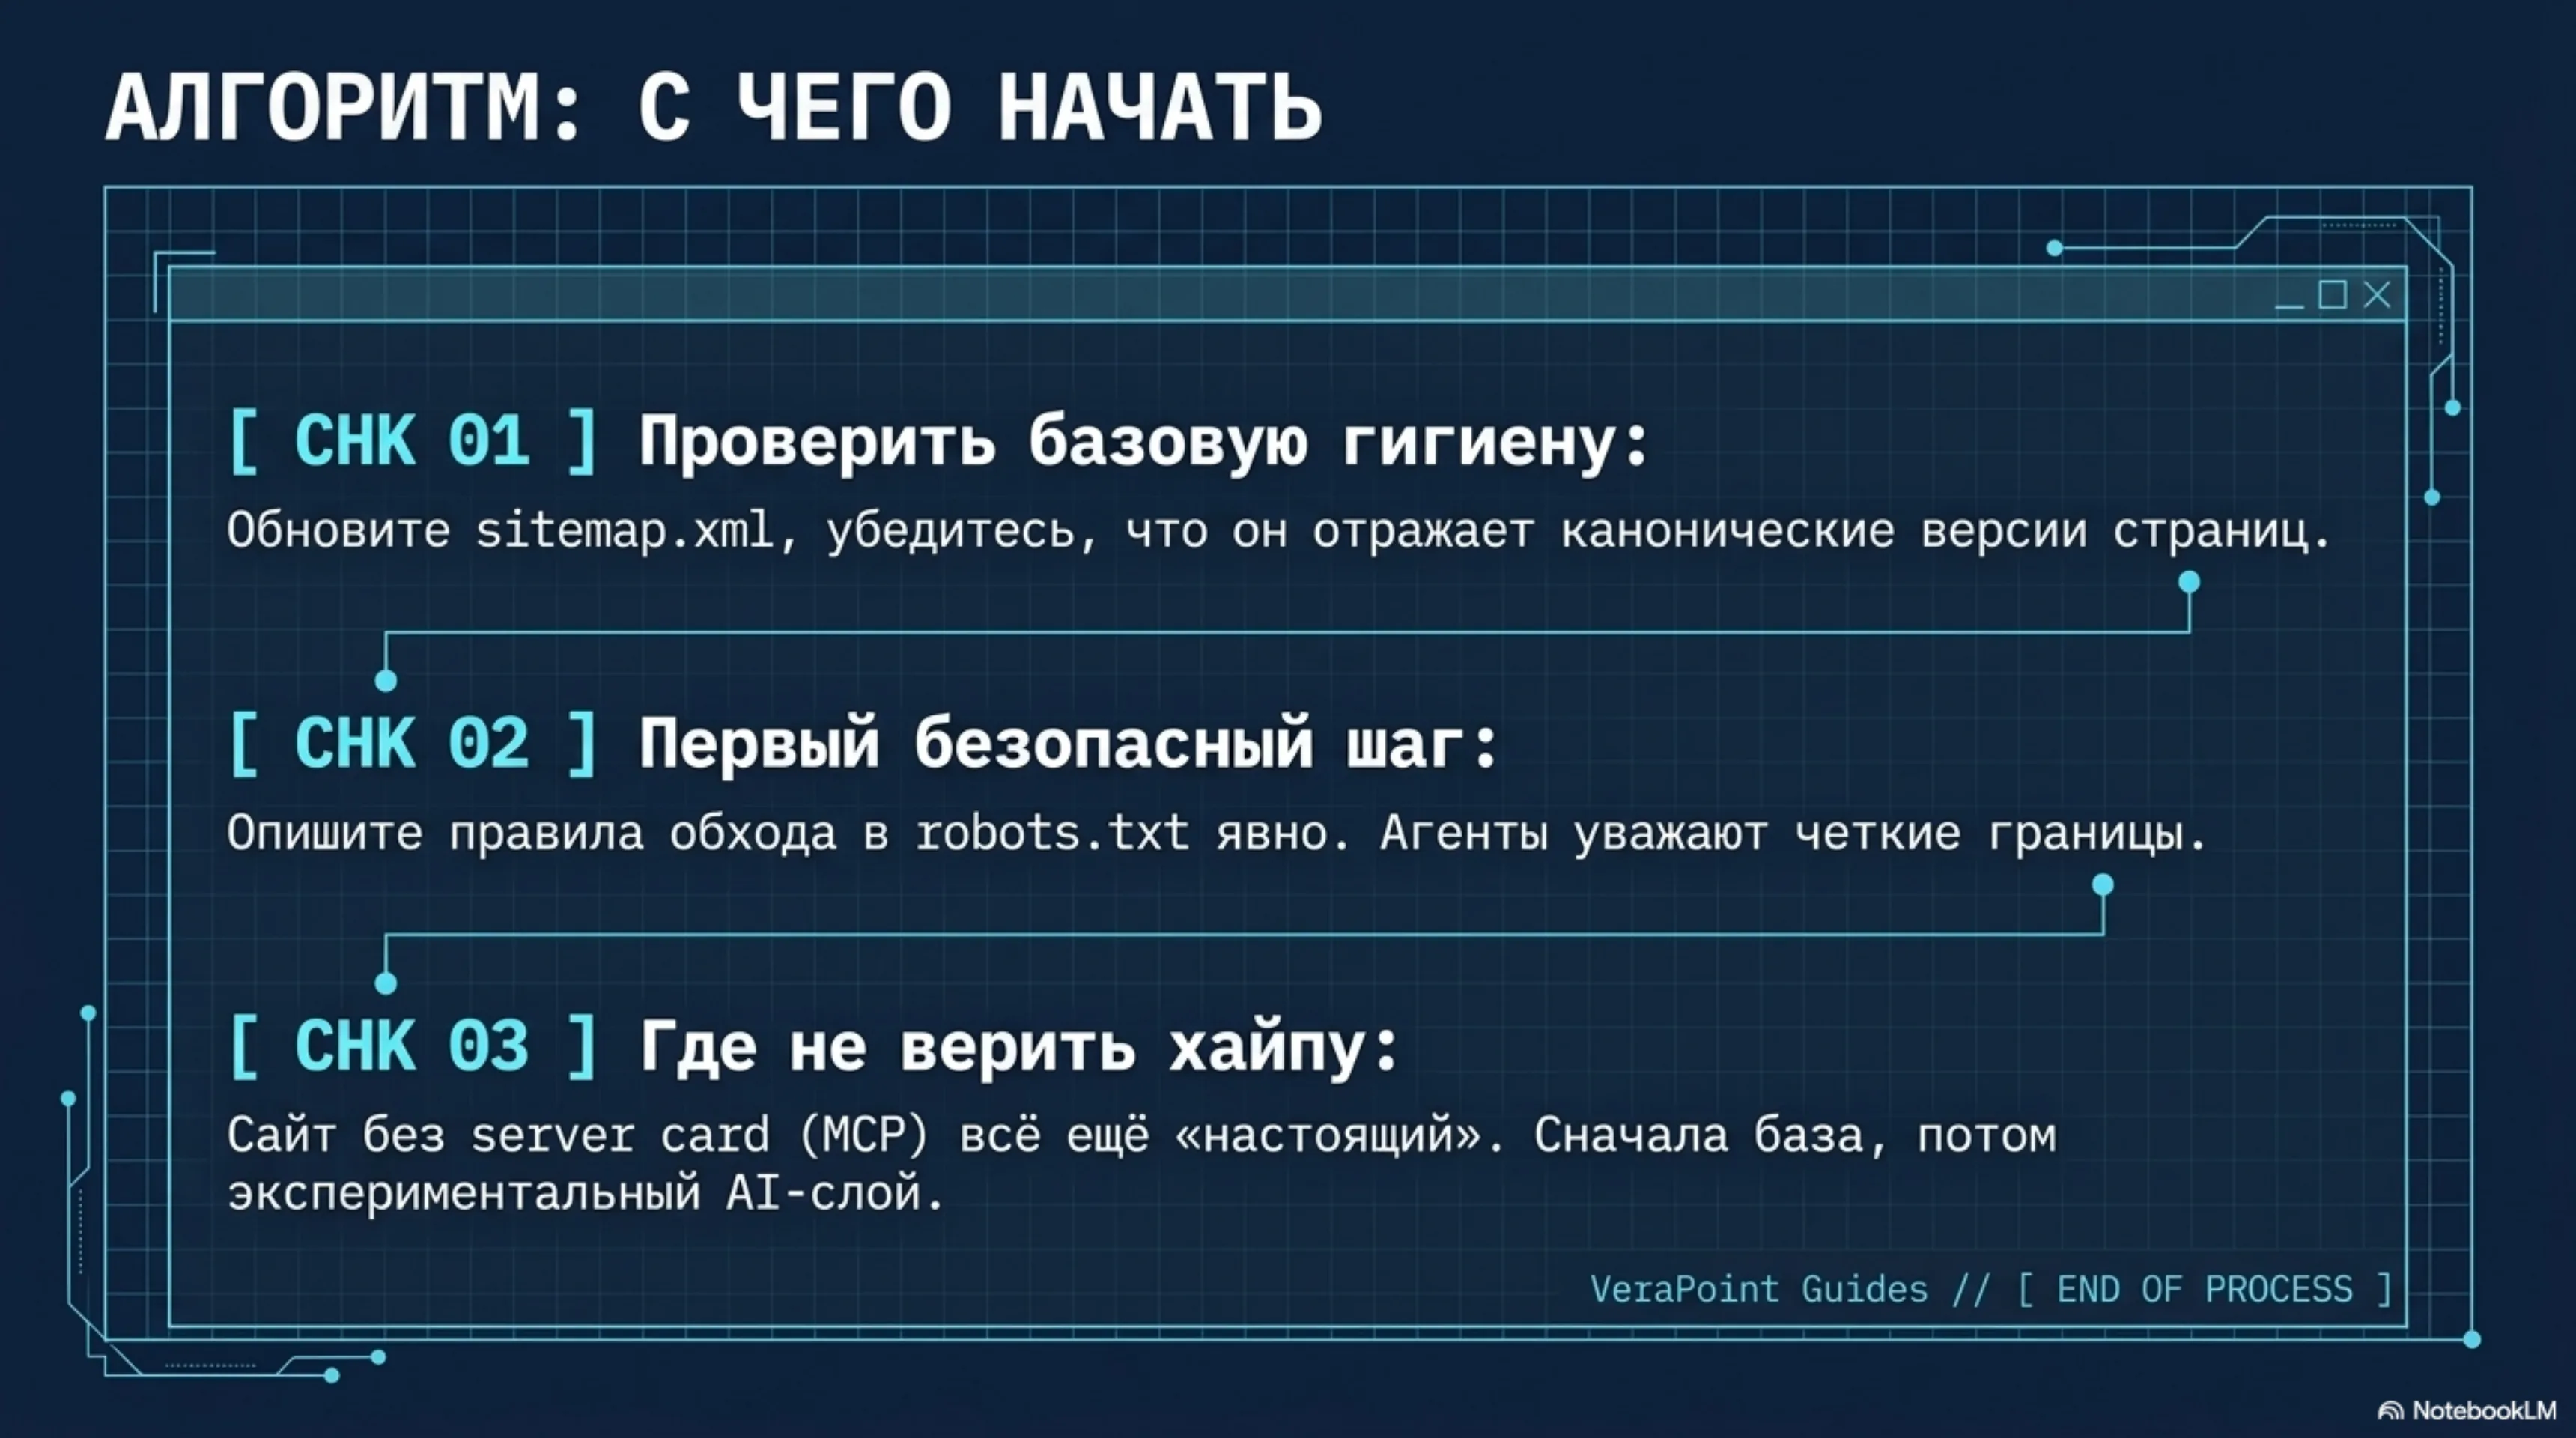
- Проверьте
robots.txtиsitemap.xml. - Убедитесь, что у каждой страницы есть canonical URL.
- Дайте RSS для обновлений.
- Добавьте structured data там, где она реально помогает.
- Подготовьте
llms.txtкак карту сайта, а не как декларацию. - Сделайте
articles.jsonили другой чистый индекс материалов. - Храните Markdown mirror для ключевых страниц.
- Если нужен машинный доступ, начните с MCP card/endpoint только для чтения.
- Не раздувайте auth-слой, если сайт пока только читают.
- Отделяйте стабильные основы от экспериментальных AI-надстроек.
Мой вывод для VeraPoint
После нашего собственного опыта с сайтом я бы разделяла это так: в VeraPoint мы смотрим на это как на два слоя, чтобы не перепутать полезную инфраструктуру с блестящей игрушкой.
Первый — стабильный веб-слой: robots, sitemap, RSS, canonical, structured data. Он нужен независимо от моды на AI.
Второй — экспериментальный слой: llms.txt, articles.json, Markdown mirrors, API discovery и MCP card. Он полезен, когда хочется дать агентам более точный вход, но его не стоит путать с обязательным минимумом для любого сайта.
Практическая ценность для редакции и бизнеса простая: меньше ручного угадывания, меньше хрупких парсеров, меньше дублирования контента, понятнее путь от публикации к машинному чтению.
Но это не универсальный стандарт для всех. Для небольшого сайта достаточно базовой гигиены. Для сложного контента и частых обновлений дополнительный AI-слой уже оправдан.
Где я могу ошибаться
AI-читаемый слой не решает всё.
Он не гарантирует качество ответа модели, не убирает галлюцинации, не защищает от prompt injection и не отменяет юридические ограничения. Если источник плохой, структурированность не делает его хорошим.
Есть и другая граница: не всем сайтам нужен полный набор llms.txt + JSON-индекс + Markdown mirrors + MCP. Иногда это лишняя работа. Сначала проверяйте, есть ли реальный сценарий чтения агентом, а не только желание «быть современными».
Если очень коротко
Сайт для AI-агентов строится не на магии, а на предсказуемости.
Сначала — стабильный веб-слой. Потом — аккуратный AI-слой. И только после этого разговоры о более сложных интеграциях.
Куда читать дальше
Частые вопросы
Что такое llms.txt?
llms.txt — это текстовый файл, который помогает AI-системам и агентам понять, какие материалы сайта важны и как их читать.
Нужен ли MCP каждому сайту?
Нет. MCP нужен, если сайт хочет отдавать агентам инструменты или структурированный доступ. Для обычного медиа сначала важнее sitemap, robots.txt и читаемые страницы.
Чем sitemap отличается от robots.txt?
Sitemap показывает важные URL для индексации, а robots.txt задаёт правила обхода для роботов.
Что сделать в первую очередь?
Проверить robots.txt, sitemap.xml, canonical, чистые HTML-страницы, скорость, структурированные данные и внутренние ссылки.
Обсуждение
Комментарии
Напишите, что думаете: согласны, спорите, увидели ошибку или хотите добавить пример. Комментарии появляются сразу; спам и мусор мы удаляем вручную.
Пока комментариев нет. Можно быть первым.